配置单上的裂缝
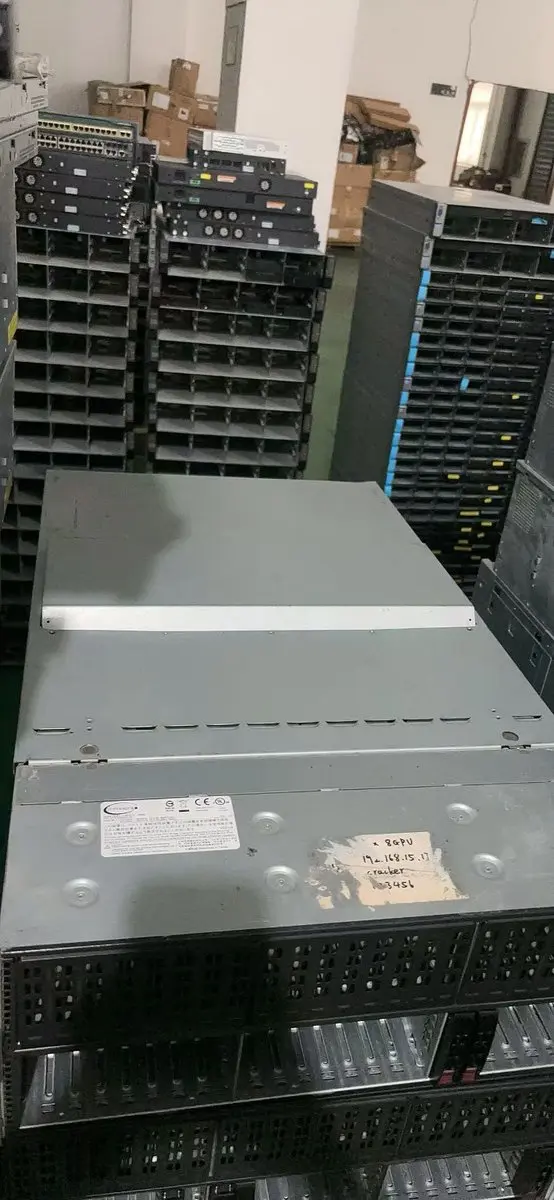
那份配置单看起来很完整。
Supermicro 4124,24个2.5英寸盘位,512GB内存,960GB SSD,3.84TB NVMe,双口25GbE,2000W双电。每一个数字都站在自己的格子里,排列整齐,像一栋已经画完施工图的楼。采购可以询价,销售可以报价,技术甚至可以顺着这些参数开始想象:双路EPYC,八张GPU,足够的内存,足够快的网络,一台低成本企业AI节点似乎只等着上电。
只有一行不对。
EPYC 7402P×2。
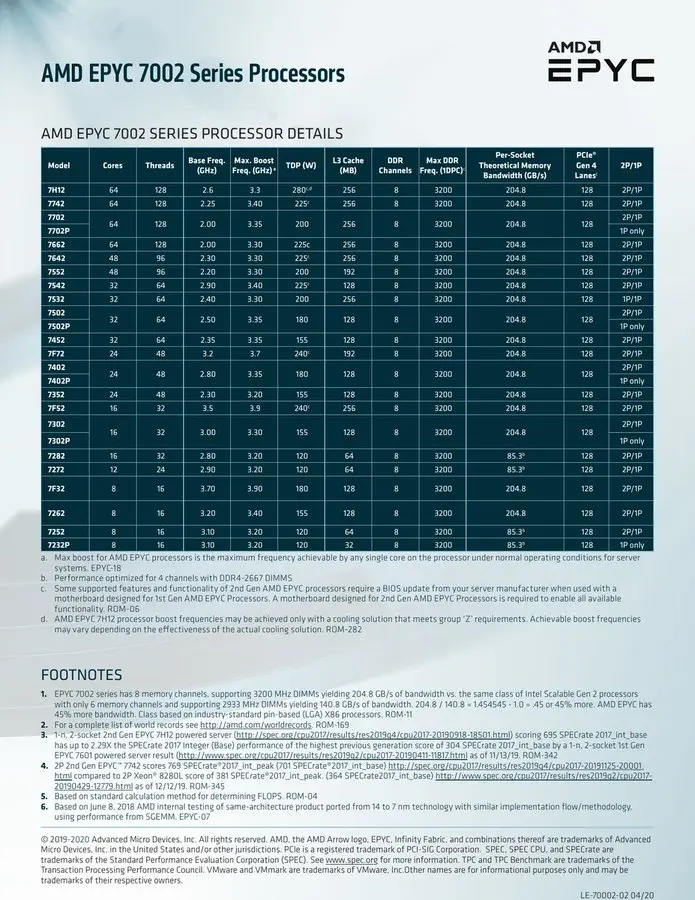
不是“不够理想”,不是“可能存在兼容问题”,而是这项配置在AMD的官方定义里根本不能成立。7402P只支持单路,那个后缀P不是装饰。能装进双路机器的是7402,不是7402P。两颗7402P不会因为被写进同一个单元格,就突然获得双路能力。
一张配置单,先裂开了一条缝。
最危险的地方也正在这里:这份表并不粗糙。它有机型、有容量、有硬盘、有网卡、有电源,甚至精确到CPU后缀。正因为它足够完整,那一行错误才更容易被完整性掩埋。人看见一排数字,会本能地把“写得详细”误认为“已经核验”;看见规格表像一张施工图,就开始在脑子里入住,却忘了先检查承重墙是否存在。
“7402P×2”可能只是供应商把7402多打了一个P。也可能不是。也许机器里装的是两颗7402,也许只有一颗7402P,也许整机、主板、CPU和配置单来自几次不同的拼装。现在不能替供应商把答案补好。必须看BIOS,必须看lscpu,必须把两颗处理器的精确型号钉死。没有这些,解释只是替一栋未验收的楼粉刷外墙。
这就是这套平台的第一处伤口。
它不是某张矿卡能不能亮,也不是某个模型能跑多少token。它先告诉人们:企业硬件里,最先杀人的往往不是缺失的信息,而是错误的信息披着完整的格式。空白会让人停下来,一张填满数字的表却会催人继续向前。报价、付款、收货、上架,一层一层压上去,直到某天才发现,地基里早就埋着一句不可能成立的话。
而这套市场叙事长期默认着另一句同样整齐的话:显存够大,硬件就有企业价值。
它并不愚蠢。至少在很长一段时间里,它非常有用。模型权重首先要放得下,上下文要占显存,KV Cache要占显存,并发也在吞显存。显存不足,很多讨论连开始的资格都没有。于是容量成了最简单、最直接、也最容易比较的数字。24GB、48GB、80GB、96GB。数字越大,门槛越低;单卡能容纳的模型越大,部署越省事。这个判断曾经像一根可靠的柱子,支撑过太多采购和技术决策。
然后CMP 170HX出现了。
它把这根柱子推到了极端,也把里面的空洞暴露出来。
64GB亮起来以后
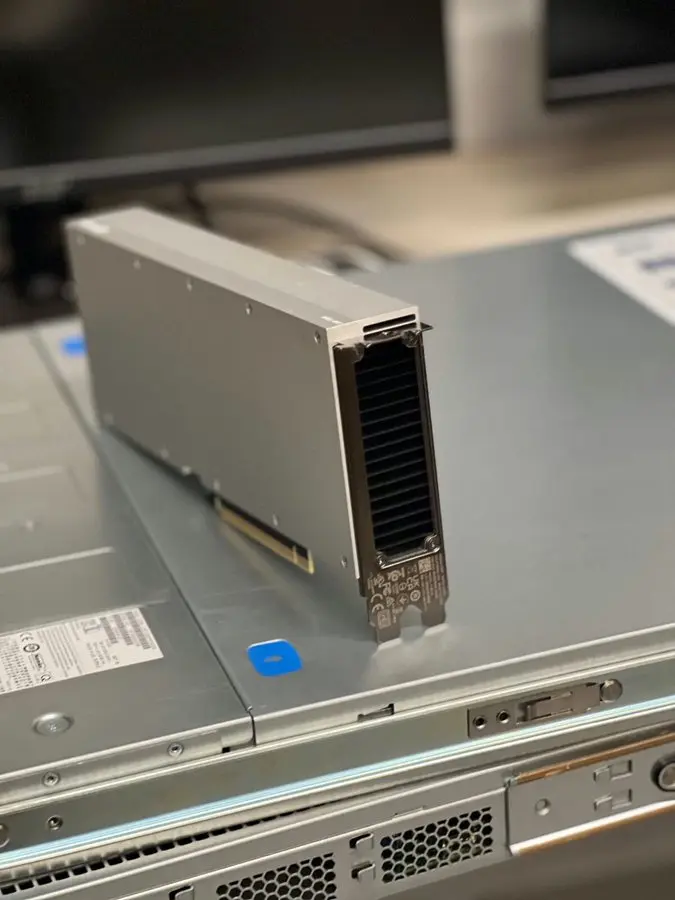
CMP 170HX原本不是为企业AI设计的产品。它是2021年面向加密货币挖矿市场的计算卡,使用GA100芯片,属于Ampere时代的产物。矿场退潮以后,这些卡像从旧建筑里拆下来的钢筋,被二手市场重新搬出来。社区逆向和解锁工作又给它通了电:解除计算节流,重写显存几何,让原本被限制的计算能力和物理资源重新可见。
于是最刺眼的数字出现了。
原始8GB的SKU,PCI ID为10de:20c2,当前社区主线的稳定口径是解锁到约64GB。原始10GB的SKU,PCI ID为10de:2082,稳定口径是约40GB。两种卡不能混着说,更不能把一张卡上的结论移植到另一张卡上。8GB到64GB,10GB到40GB,这是两条不同的显存几何路径,不是一句“矿卡都能解锁大显存”可以抹平的细节。
至于10GB到80GB,那是更诱人的废墟。
它被尝试过,但约40GB以上会出现不稳定。80GB可以出现在实验记录里,不能出现在企业交付承诺里。能枚举出来,不等于能持续写入;能跑一次,不等于能经过长时间负载;某一张样卡碰巧通过,不等于一批二手卡都能承担同一个SLA。企业客户不会为“偶尔成功”付费,他们最后会把每一次掉卡、错误、服务退出和不可复现,都沿着合同追到交付者身上。
所以80GB不是多出来的四十GB。它是一层尚未封顶,却已经有人想挂牌出售的楼面。
这时,旧信仰开始死亡。
如果显存够大就天然拥有企业价值,那么8GB解锁成64GB的那一刻,价值应该已经完成。八张卡就是512GB,数字巨大,成本又低,故事到这里本该结束。可真正把它放进企业环境,所有被容量遮住的问题会同时回来:这64GB能不能稳定读写?卡与卡之间如何通信?驱动能不能冻结?升级会不会失效?有没有ECC?有没有官方支持?坏一张以后谁来换?同一批卡的显存、温度、功耗和维修史是否一致?
显存只回答了一件事:东西能不能放进去。
企业价值要回答另一件事:放进去以后,谁保证它不会在无人注意时腐烂。
这两个问题不能再被写成同一个问题。容量是材料,不是建筑;能够上电,是废墟里的钢筋还没有完全锈断,不代表楼已经能住人。过去那句“显存够大就有企业价值”之所以迷人,是因为它把责任压缩成了一个数字。数字没有售后,不会半夜报警,也不需要为静默错误签字。可企业系统不是跑分截图。企业买下的从来不是某一刻亮起的显存,而是这块显存在一个月、一年、一次驱动升级和一次硬件故障之后,仍然有人知道该怎么办。
旧信仰不是被一个更漂亮的理论杀死的。它死在配置单上那个小小的P里,也死在80GB那条不稳定的边界上。前者证明文字可以伪装成硬件,后者证明容量可以伪装成可靠性。两种伪装的共同点是:只要暂时不验收,它们都显得很便宜。
这里甚至有一种残忍的对称。
7402P×2,是把两颗不能双路的CPU写成了双路;10GB→80GB,是把尚未稳定的地址空间写成了容量。一个错误发生在主机端,一个诱惑发生在GPU端。它们隔着主板、线缆和驱动遥遥相望,却使用同一种语言:先给你一个足够大的数字,让你舍不得停下来核验。
采购最容易在这时背叛工程。不是因为采购不懂技术,而是所有人都被进度推着走。卖方说大概率是笔误,买方觉得机器便宜,技术认为到货以后再查也来得及。每个人只让一步,没有人觉得自己做了严重决定。可楼就是这样歪的。没有哪一块砖单独承担坍塌,直到所有微小妥协叠在一起,最后一张错误配置单反而成了唯一写得最清楚的东西。
所以这次不能先问“值不值得买”。先问“什么是真的”。
CPU要从BIOS和lscpu里确认,不能从销售解释里确认。GPU要按PCI ID分清8GB和10GB两个SKU,不能看外壳差不多就混成一批。解锁后的容量要做显存写读和地址模式测试,不能只截一张nvidia-smi。80GB既然在40GB以上出现不稳定,就必须退回40GB交付,不许拿最漂亮的一次启动覆盖后面的错误。所谓企业化,最开始并不宏大,不过是拒绝替任何一个未经验证的数字圆谎。
显存神话真正杀死的,是这种拒绝能力。
当64GB出现在屏幕上,人很容易立刻乘以八。八张就是512GB。接着开始换算能装多大的模型、能省多少采购费、能不能替代更贵的卡。每一步算术都可能正确,结论仍然可能是一座违章建筑。因为乘法只负责汇总容量,不负责补上ECC,不负责打通卡间互联,不负责提供官方驱动,也不负责在某张二手卡出现HBM错误时告诉你,哪一次推理结果已经不再可信。
这正是必须被埋掉的旧信仰。它曾经帮人快速筛选硬件,现在却会让人快速跳过责任。显存仍然重要,甚至是这批卡重新获得价值的起点;但起点不是产权证。64GB只允许我们走进工地,不允许我们宣布竣工。
它有GA100的血缘,但它不是A100
把CMP 170HX叫作“廉价A100”,是这套故事里最省力、也最危险的一步。
它们确实有血缘。CMP 170HX使用GA100硅片,PCB也高度接近A100 40GB PCIe参考设计。它的Compute Capability是8.0,也就是sm_80;两种SKU都暴露70个SM、4480个CUDA Core。社区解除计算节流以后,FP32和Tensor计算可以恢复到这套70SM配置应有的水平。它不是一块只有大显存、没有计算能力的空壳。
它的标称软件功耗上限约250W,全被动散热。这个250W也不能孤立阅读。被动卡没有自己的风扇,它默认自己活在服务器的强制风道里。离开4U服务器的高静压风墙,把它摆进普通机箱,再拿“250W不算高”安慰自己,等于从旧楼里拆下一段钢梁,却把原来的支撑条件一起忘了。功耗是卡的数字,散热是整机的责任。
HBM带宽同样很诱人。社区在不同工具、不同读写方向和不同条件下测得的区间,大约是1.3到1.7TB/s。可以说它保留了GA100/HBM体系的高带宽优势,但不能从区间里挑一个最高数字,磨成铭牌,再当作无条件的官方规格。解锁计算本身也不会凭空增加HBM带宽。工具怎么测、方向是什么、显存SKU是哪一种、负载如何,都会影响结果。
这就是所谓“条件性”。
1.3—1.7TB/s是一组在具体测试条件下出现的社区测量,不是每张卡、每个任务、每一次运行都能兑现的固定承诺。企业可以使用这个能力,却不能假装条件不存在。废墟里挖出的材料需要逐根检测,不会因为它曾属于某种宏伟结构,就自动继承那栋楼的验收证书。
更不能因此把它写成A100。
A100不是“GA100芯片加一块大显存”这么简单。CMP 170HX只有70SM、4480 CUDA Core;解锁不会长出更多SM。它当前没有已知可用的ECC解锁,没有可用NVLink,社区结论里P2P也缺失,更没有NVIDIA针对A100那套官方企业驱动、认证和支持责任。它们共享硅片家族,不共享完整产品身份。血缘是真的,等价是假的。
这些缺口不是规格表末尾的小字,它们会改变系统的建法。
ECC缺失,意味着不能把它包装成正规数据中心卡那种关键任务可靠性。应用层需要校验、重试和故障隔离,关键业务也不能把一个节点当成唯一真相。NVLink和P2P缺失,意味着多卡并不是把卡插满就完成了;计算可能在八张卡上,数据却要受另一套路径约束。官方企业支持缺失,则意味着驱动、内核、升级和回滚都落到交付者自己身上。那些在A100产品身份里被厂商承担的部分,到了170HX这里,全部变成施工成本。
所以“同为GA100”只说明材料的来历,不说明建筑的等级。两根钢材出自同一炉,不代表装进不同结构后拥有同一份承重证明。170HX能恢复70SM配置应有的计算能力,这是它真正珍贵的地方;但恢复计算,不等于恢复整个产品。社区解锁可以解除节流、重写显存几何、推进PCIe链路,却不能凭愿望补出缺失的企业责任。
这句话必须说重一点:CMP 170HX不是A100。
不是残血A100,不是改个驱动就能毕业的A100,也不是采购话术里的“A100平替”。它是一张面向挖矿市场、基于GA100、被社区重新打开部分能力的计算卡。它有自己的70SM、自己的4480 CUDA Core、自己的CC 8.0、自己的250W边界,也有自己无法靠软件补出的缺口。承认这些,不会降低它的价值;恰恰相反,只有拒绝冒充,才可能给它建立真正的产品位置:成本优化型的大显存推理卡,适合被工程化、被分级、被监控、被替换,而不是被神话。
很多人不愿意这样写,因为“A100”三个字能让废墟突然显得像地标建筑。客户认识它,市场理解它,销售也容易算账。但名字借来的信用,迟早要由交付偿还。没有ECC时发生的风险,不会因为报价单上写了“同源”就消失;没有NVLink和P2P时,多卡通信也不会因为大家都出自GA100而自动打通;社区补丁失效时,NVIDIA不会因为你曾经把它叫作A100,就替你接管现场。
真正的企业价值不是把身份写高一点,而是把边界写低一点,再证明自己仍能交付。
这也解释了为什么一张卡的身份不能只靠芯片代号判断。芯片像建筑材料的牌号,产品却是整套结构:启用了多少单元,接出了多少链路,显存怎样组织,错误怎样发现,驱动由谁维护,故障由谁负责。只抓住GA100,就像在废墟里找到一块刻着旧楼名称的构件,于是宣布整栋楼仍然存在。可原来的楼已经没有了。现在面对的是另一块PCB、另一组产品限制、另一条社区驱动路径,以及一份必须由交付者重新写下的验收标准。
这条路径本身也不能被藏起来。当前解锁依赖Linux x86-64、经过修改的nvidia-open驱动,并要求关闭Secure Boot。它不是插卡后安装通用官方驱动就结束。内核与驱动组合要冻结,镜像要保存,升级要灰度,失败要能回滚。客户看见的是64GB,交付者背后维护的是一整条脆弱却必须可重复的施工通道。只展示解锁结果,不展示它依赖什么,和只给客户看精装修样板间、却不交代水电从哪里走,没有本质区别。
因此,解锁成功最多证明材料可用,不能证明批量可交付。一张卡跑通,是实验;同一批卡逐张建档,是生产的开始。显存写读、地址模式、温度、功耗、PCI ID、VBIOS、PCIe链路、Xid错误,都要留下记录。否则所谓64GB只是一个没有房号的空间:今天看得见,明天出了问题,却不知道是哪一面墙先裂开的。
边界写得越清楚,CMP 170HX的价值反而越稳。它不需要赢过A100,也不需要假装拥有完整的数据中心身份。它只需要在自己真实存在的条件里,证明大显存、HBM带宽和70SM计算能力能被重复调用,证明坏卡可以被识别,异常可以被隔离,系统可以退回已知状态。企业价值从来不是无缺陷,而是缺陷出现以后,系统仍有秩序。
64GB是真的,但它属于8GB SKU的当前稳定解锁口径。40GB是真的,但它属于10GB SKU。80GB存在过,但不稳定,所以不能卖。70SM、4480 CUDA Core、CC 8.0和250W是真的,它们共同描述的是CMP 170HX,不是A100。1.3—1.7TB/s也可以是真的,但它必须和测试条件绑在一起,不能被铸成一块永远不变的门牌。
当这些数字被逐一放回自己的位置,那栋想象中的廉价A100大楼就塌了。留下来的不是一堆毫无价值的垃圾,而是一批仍然有用、却必须重新测量的材料。它们能建什么,不能由显存容量单独决定;要看底座、供电、风道、驱动、监控、备件,也要看数据怎样进出每一张卡。
而下一道裂缝,正藏在“进出”两个字里。
服务器给的是PCIe 4.0 x16槽位,不代表这张卡就拥有PCIe 4.0 x16。链路代际和物理宽度是两道不同的门。等这道门真正打开,八张64GB卡组成的“512GB”,也会显出它最容易骗人的形状:八间各自上锁的房间,被配置单加在一起,便被误写成了一座没有墙的大厅。
两道门,和一座不存在的大厅
服务器给了PCIe 4.0 x16插槽,不等于卡就拥有PCIe 4.0 x16。
这句话看起来像常识,落到采购表里却经常失踪。平台规格和端点能力被写在相邻的两列,人眼一扫,就把它们接成同一件事。于是4124的PCIe 4.0,悄悄长到了CMP 170HX身上;八条宽阔的高速公路画好了,所有人便假设车也能按那条路的速度跑。
可这张卡前面有两道门。
第一道门是代际。社区当前主线把原来的Gen1推进到了Gen2,这是软件路径已经取得的成果。第二道门是宽度。卡的物理训练宽度仍然是x4,不会因为插进x16槽位就自动变宽。Gen2和x4不是同一个问题:一个回答每条车道能跑多快,一个回答到底有几条车道。只打开第一道门,第二道门仍然锁着。
想把x4补成x16,需要在高速差分区域补24颗0402 AC耦合电容。那不是改一个配置项,也不是刷一版驱动,而是在PCB上动刀。焊点很小,区域敏感,返修风险真实存在。公开样本表明,完整宽度改造配合Gen2可以把host到GPU的带宽推到约6GB/s级,但样本不多,卡况、工艺和平台条件也不相同。它可以是一条实验路线,不能成为首批企业节点默认施工动作。
先把Gen2 x4的稳定性做完,再决定是否值得承担硬件返修风险。企业交付最怕的不是性能少一点,而是为了一个漂亮数字,把原本还能更换的旧材料改成了无法批量复现的手工作品。每张卡都要靠某个人的焊台和手感活着,那就不是标准化节点,而是一排被精心保存的偶然。
至于Gen3和Gen4,当前仍未解决。不能因为4124的主板支持Gen4,就把未来时态提前印进今天的产品册。底座的路修到了四代,端点仍停在二代四车道。那条路不是不存在,只是这辆车还开不上去。
这会把所有多卡幻想拖回物理世界。
原厂状态下,host到GPU的典型实测大约只有0.80—0.85GB/s;当前主线Gen2 x4大约1.68—1.71GB/s。数字并不羞耻。羞耻来自明知它只有这个边界,却继续按照现代高速互联卡的方式设计系统,再把通信造成的等待归罪于模型。
低速链路不是一个可以靠情怀越过的坑。它会出现在模型加载里,出现在CPU和GPU之间的数据搬运里,出现在多卡同步里,出现在每一次过于频繁的collective通信里。平时它像墙里的潮气,只让任务慢一点;并发一高、上下文一长、并行策略一错,潮气就会沿着整面墙浮出来。
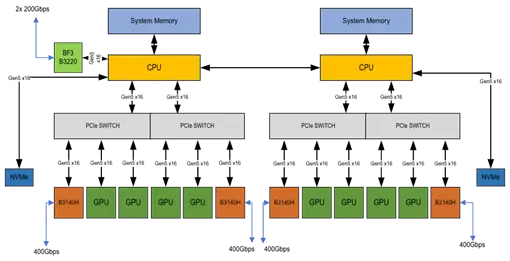
然后是那座最诱人的大厅:八张64GB卡,合计512GB显存。
乘法没有错。八乘六十四就是五百一十二。错的是把“聚合本地显存”写成“统一显存池”。这八张卡各自拥有64GB本地显存,八个空间彼此独立。当前没有可用NVLink,没有P2P,PCIe又停在Gen2 x4。系统不会因为管理页面把数字相加,就突然得到一块可以任意寻址、任意切分、任意高速互访的512GB显存。
它更像八间各自上锁的房间。
每间房都不小,甚至足够独立住下一类模型。可是钥匙不相通,墙也没有消失。你可以安排八个住户,可以让一个大模型按楼层分段,也可以在门外放一个路由员;你不能把八张房产证叠在一起,然后宣布这是一座没有隔墙的大厅。
这条边界决定了最稳妥的商业形态。
只要模型能在单张64GB卡里放下,优先做一卡一副本。每张卡跑一个独立模型实例,前面用API Router做负载均衡。八张卡不是绑成一个脆弱的大脑,而是八个可以独立接单、独立升级、独立失败的房间。一张掉卡,路由把请求移走;一个副本升级,不必让整台节点同时停服;并发增加,靠副本横向分摊。
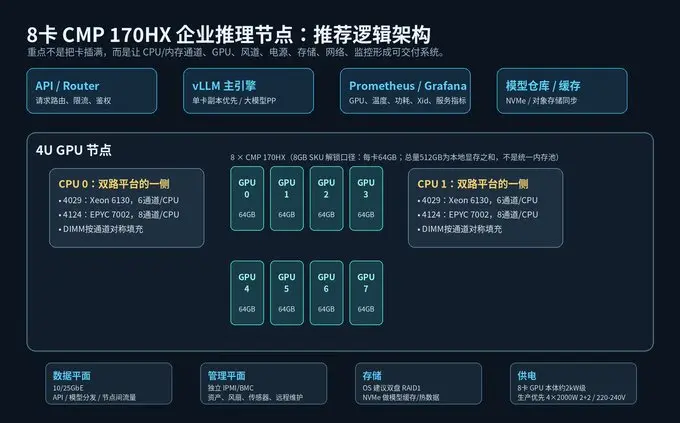
这种设计看起来没有“512GB统一大显存”那么壮观,却更像生产。它绕开了170HX最明显的PCIe和P2P短板,把硬件真正擅长的东西留下:单卡大显存、HBM带宽、可用的70SM计算能力,以及低采购成本下可以铺开更多副本的空间。
如果模型确实大到单卡放不下,也不能本能地选择Tensor Parallel。
TP会让多张卡在每层计算中频繁交换和同步。现代高速互联上,这种代价可以被吸收;在Gen2 x4、无P2P的170HX上,通信会被成倍放大。Expert Parallel也有同样问题:专家之间的路由一旦频繁跨卡,原本应该用于计算的时间,就被耗在狭窄的门口。
更合适的方向是Pipeline Parallel。把模型按stage切开,每张卡负责连续的一段层,数据沿着流水线向前走。每个token在stage之间传递activation,通信频率和形态更适合这种低主机互联带宽。社区在具体模型与条件下的直接对比,也指向PP优先的设计方向。但这仍然不是万能结论。模型结构、量化方式、上下文、batch和引擎都会改变结果,任何一次tokens/s都不能脱离条件成为这张卡的永久铭牌。
原则只有一句:让计算尽量留在房间里,让穿墙的次数尽量少。
同样的诚实也要放到节点之间。
4124的双口25GbE对企业推理很有用。它可以承担模型分发、对象存储访问、API入口、独立副本池、日志和向量库;可以把多台节点组织成服务层,让流量在可用副本间转移。4029的双口10GbE也能做基础节点和副本路由。这些都是实实在在的能力。
但25GbE不是现代scale-out AI Fabric。它不能被包装成每GPU 200Gb/s级东西向网络,也不适合拿来支撑通信密集的大规模训练或跨节点重并行。网络能做什么,就让它做什么:分发模型,承接请求,搬运日志,连接对象存储。不要让一条服务网络去冒充一条它从未成为的高速互联骨干。
于是,512GB的幻觉被拆开了。
八间房还在,甚至比最初更有价值,因为它们终于有了门牌、用途和故障边界。真正消失的只是那座不存在的大厅。企业平台不需要把墙说没,它需要知道墙在哪里,门有多宽,哪一间断电后可以被隔离,哪一条走廊拥堵时应当停止增加住户。
但房间能不能长期使用,最后仍取决于楼。
卡只是被搬回来的钢筋。承重墙、内存通道、风墙、电源、系统盘、管理口和网络,才决定这些钢筋会被重新建成一座可交付的建筑,还是继续堆在废墟里,等下一张更漂亮的配置单替它们起名。
三、承重墙:企业价值藏在无聊处
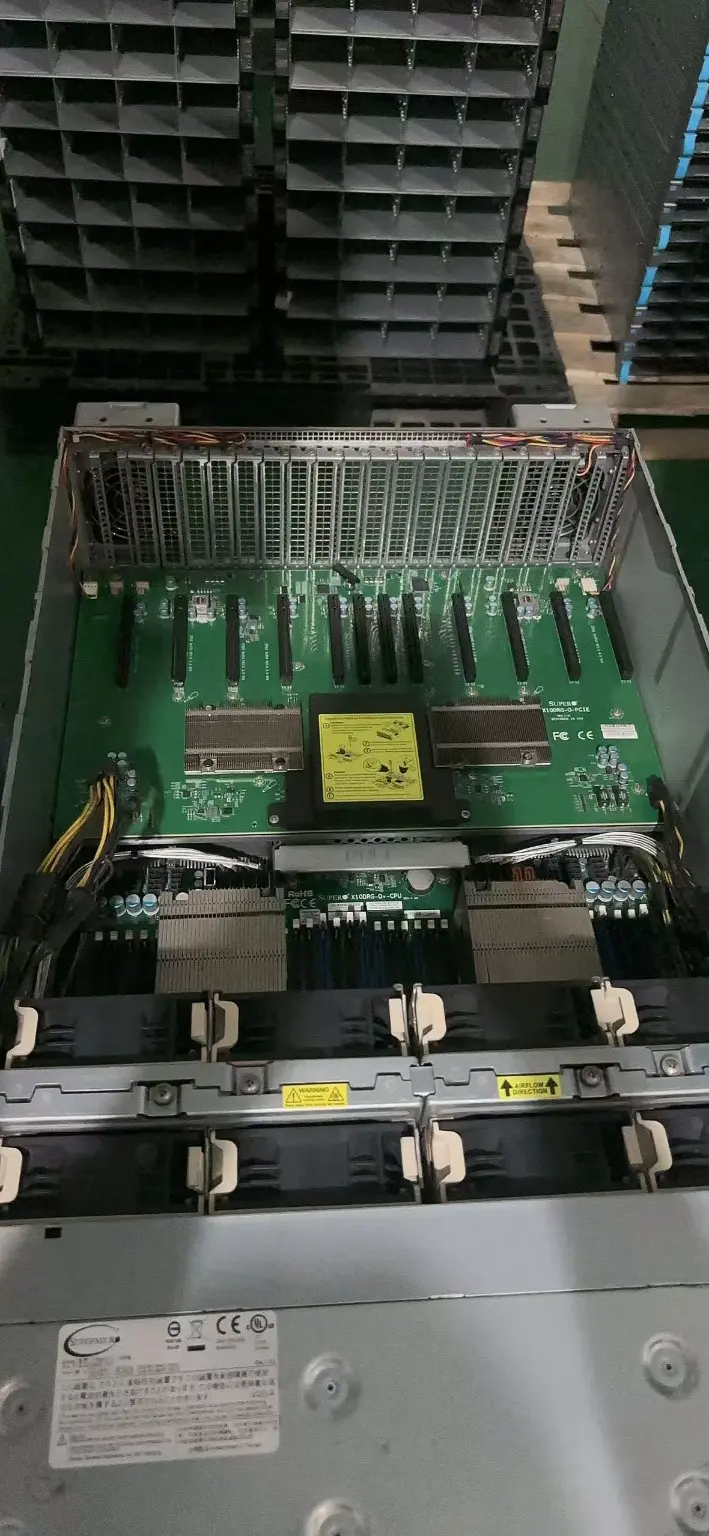
所有目光都落在显卡上。八张卡,八块从矿场废墟里拖回来的硅,人们围着它们估价、争论成色,像围观从倒塌大楼里抽出的钢梁:这块料还好吗,裂了没有,还能撑几年。没有人抬头看楼本身。地基,承重墙,配电井,通风道。一栋楼塌不塌,从来不取决于大厅里挂着什么,而取决于那些没人愿意多看一眼的部分。楼是站着死的,也是站着活的。站在结构上,死在结构上。
服务器也一样。废墟里能站住的,从来不是装修最亮的房间,而是结构没被砸坏的框架。而结构,恰好是整个行业最不愿意谈论的东西——因为它无聊。无聊到没人拍照,无聊到写进方案里像在凑页数,无聊到销售念到这里会自觉放低声音。可是每一台真正跑过五年、换过三拨业务、深夜被叫醒过又活下来的机器,靠的都是这些段落。光会灭,柱不会。
先把两块框架说清楚。一个字都不能含糊,含糊的规格是另一处看不见的裂缝,裂缝都在没人读的段落里。
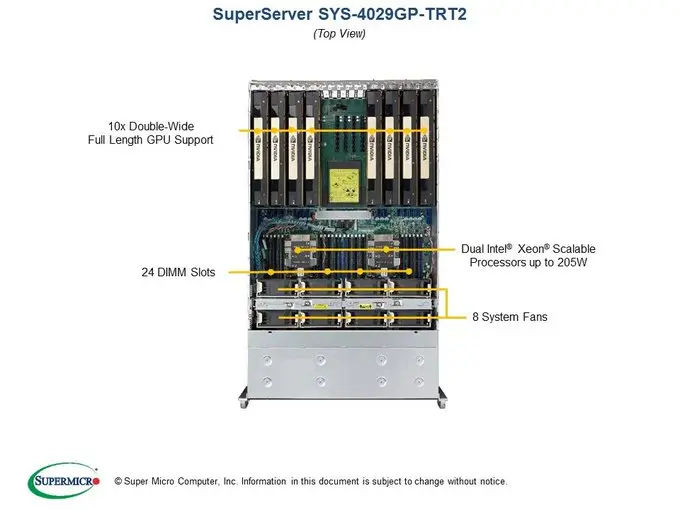
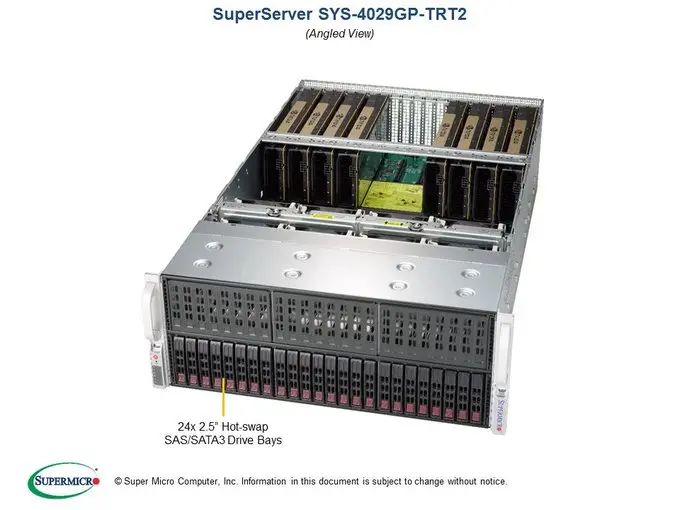
第一块,Supermicro 4029。4U的机架,双LGA3647插座,24个DIMM槽,PCIe 3.0,最多24个2.5寸盘位,板载两路10GBase-T,8颗92mm热插拔风扇。以4029GP-TRT2这个尾标为准,官方列了11条PCIe 3.0 x16加1条x8,最多能装到10张卡;TRT变体则明确写着8张双宽卡。买这台机器要核对完整尾标,同一个数字家族里住着好几种不同的楼。官方完整供电是四颗2000W电源,2+2结构。CPU配双Xeon Gold 6130:每颗16核32线程,每颗6个DDR4内存通道,两颗加起来,12个通道。这个数字要记牢。十二。不是十,不是十六。十二。
第二块,Supermicro 4124。同样是4U,双AMD EPYC 7002或7003,原生8个双宽GPU位,Dual-Root结构,GPU直连PCIe 4.0 x16。32个DIMM槽,最高8TB DDR4-3200;官方页面白纸黑字写着,最佳性能是插16条内存,厂商把答案印在了图纸上,只是没人翻到那一页。EPYC 7002每颗8个内存通道,双路16个通道。存储上原生2个SATA口做RAID1、4个NVMe位;8颗11500转的重型风扇;IPMI 2.0带KVM over LAN。官方完整供电同样是四颗2000W,2+2。
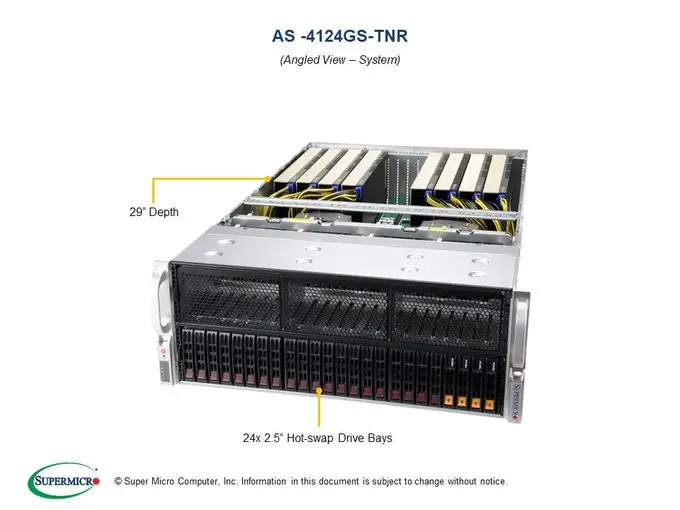
十二对十六。这两组数字比任何跑分都无聊,也比任何跑分都诚实。跑分会说谎,负载会变,benchmark可以挑,通道数印在主板上,一颗都不会多。内存通道是一栋楼的承重柱:柱子立着,数据才有路走;柱子空着,再大的厅堂也是危房。后面所有关于这三台机器的判断,都要回到这两组数字上。它们是本部分的地面,一切在它上面展开。
顺便说穿一个常见的错觉:4124主板能给PCIe 4.0 x16,不等于卡就能跑到Gen4。槽位是路,卡是车,车只肯开Gen2 x4的速度,八车道的路也拦不住它慢。平台的先进喂不进端点,这是另一处容易被规格表骗过去的地方。
所以就有了那个必须掰开的问题:512GB,到底拉满了什么。
先说为什么死抠通道。推理不是只有显存在干活:请求进来要先过CPU,tokenizer切词、调度器排队、批处理重组、结果序列化,全在内存里来回搬。通道多而均匀,这些搬运就有足够宽的路;通道空一半,CPU再快也要等数据。楼上住多少人是一回事,楼梯修了几部是另一回事。
答案分两层。第一层很冷:4124的内存容量上限是8TB,512GB离拉满差得很远,把它写成内存顶配是看错了图纸,把杂物间认成了天台。第二层藏在条数里:如果这512GB由16条32GB组成,双路EPYC的16个通道,每条道都插了一条DIMM,一通道一条,1DPC,通道占用完整。这叫带宽拉满,不叫容量拉满。同样512GB,换成8条64GB,只覆盖一半通道,容量没变,楼里却有一半承重柱是空的,数据走到那里就要绕路、排队、慢半拍。两种配置在规格表上写成完全相同的四个字符,在机箱里是两种完全不同的结构。表上一样,楼里不一样。而所有失败的事故报告,写的都是表,不是楼。
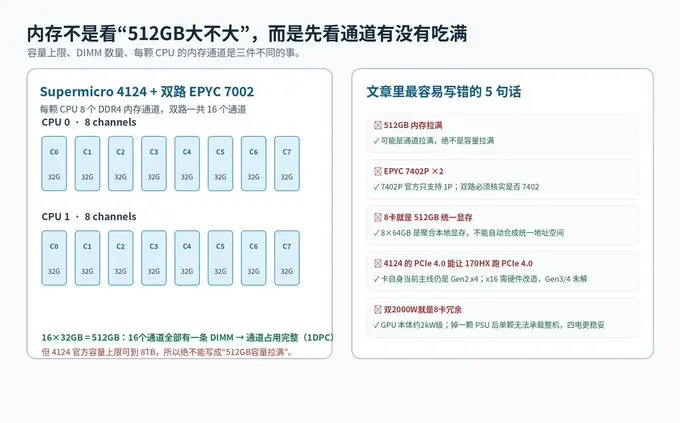
所以拿到任何512GB的机器,第一件事不是看总容量,是让供货商报清单:几条,每条多少GB,什么频率,几个Rank,插在哪些槽,各归哪颗CPU。不再接受一个光秃秃的数字。数字越漂亮,越要问它是怎么凑出来的。漂亮的总数是最大的陷阱,它把八种结构压扁成一个词,把裂缝压扁成没有。
4029那边的256GB同理,甚至更糙。双6130是12通道,256GB可以是8条32GB,可以是16条16GB,通道覆盖和两颗CPU之间的对称性完全不同,而推理时tokenizer、调度器、网络栈就跑在这些柱子上。宁可要条数和布局说得清清楚楚的内存,也不要只报总量的糊涂账。一栋楼可以旧,但不能有一张说不清承重结构的图纸。说不清图纸的楼,每一次改造都是赌博,每一次扩容都在加注。
手里三台机器,就按这个办法照X光。同一批废墟,照出三种骨架。
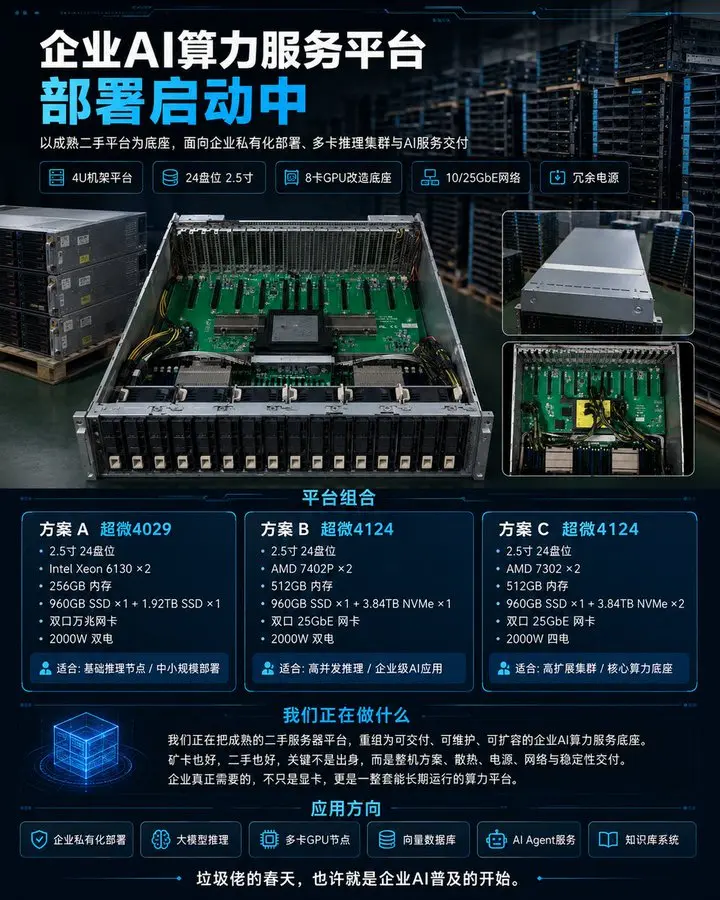
方案A,4029,双6130,256GB,一块960GB SSD加一块1.92TB SSD,双口10G,卖方写2000W双电。双6130合计32核64线程。定位:低成本的副本节点,基础的推理入口。它就是楼群里那几间朴素的偏房,模型放得下,请求接得住,撑主力不指望它。老平台,老得诚实,老得知道自己只该做什么。偏房有偏房的用处:主力楼检修的时候,请求还有地方落。
方案B,4124,卖方写7402P两颗,512GB,一块960GB SSD加一条3.84TB NVMe,双口25G,同样写2000W双电。如果CPU实际是7402双路、内存真是16乘32,合计48核96线程,它是三台里CPU、内存、网络最均衡的主力底座。但那两个如果,必须当场拆开验。如果这个词在采购里不是假设,是风险敞口。
先拆CPU。7402P在AMD官方规格表里只支持单路,一颗孤立工作的芯片,天生只能独居;能双路的是7402,不带那个P。卖方写成7402P两颗,要么是抄单时的笔误,要么是不懂平台,要么是明知故省。不管是哪一种,钱付出去之前,必须亲眼看到BIOS界面或者lscpu的输出,不是听解释,是看屏幕。一个字母的差别,是一整台机器一半的算力结构。废墟里最贵的错误从来不是买到旧东西,是把图纸看错一个字,然后照着错误的图纸往下盖。盖得越认真,塌得越完整。
再拆内存。512GB是不是16乘32,决定主力底座这五个字成不成立。是,16根柱全立着;不是,就退回一半柱子的楼,名字再好听也只是名字。
方案C,4124,双7302,512GB,一块960GB SSD加两条3.84TB NVMe,双口25G,四颗2000W。双7302合计32核64线程,核心数比7402少,但对推理服务的编排足够。四电、双NVMe、25G,三台里它最接近能直接交付生产的底座。仍要照X光:512GB的条数分布、每块盘的SMART和通电小时、每颗电源的健康日志、八卡满载下的热稳定。交付不是签收,是验收清单全部划勾的那个时刻。
A是入口,B是赌注,C是交付。三台机器,三种命运,压在从不出现在宣传图上的那些参数里。宣传图上只有显卡在发光,其余部分都在阴影里。而阴影里的东西,才是这栋楼。
然后是电。这一段最无聊,也最致命。电流是这栋楼地面之下看不见的地下水,没人谈它,直到墙面渗水那天。
先算账。八张卡,每张标称250W,仅GPU本体就约两千瓦。加上双CPU、内存、风扇、硬盘、网卡、主板和转换损耗,整机峰值还要更高。官方完整方案里,4029和4124都是四颗2000W组成2+2:平时四颗分担负载,坏掉一颗,剩下的三颗接得住满载的八卡节点。四颗电源,才是这个机架被设计出来时的样子,两颗是省出来的,省的地方从来不在图纸上。
而卖方嘴里的双电——两颗2000W——听着也有冗余,坏一颗还剩一颗。可一颗2000W托不住满载的八卡。所谓双电,冗余的是不宕机这个概念,冗余不掉负载本身。掉电那一下,机器不会优雅降速,不会体面地只跑四张卡,它只会死。半夜三点,死在负载最高的时刻,死在最多人用着的那个小时。冗余这个词在规格表上免费,在物理上从来不免费。
还有更冷的一行小字。2000W要在230到240伏的交流高线输入下才接近满额;100到120伏的环境里,这颗电源只输出约1000W。也就是说,把机器搬进一个110伏的机房,哪怕四颗电源齐装,实际供电能力直接砍半:机箱里站着四颗电源,地底下只流着一半的电流。PDU、插座、线材、空开,全都要按高线重新设计,一条链路上任何一个环节按低线敷衍,整条链路就按低线活着。废墟里的设备最怕的不是旧,是你以为它站在坚实的地面上,其实地面早就被挖空了。
电之上是风。
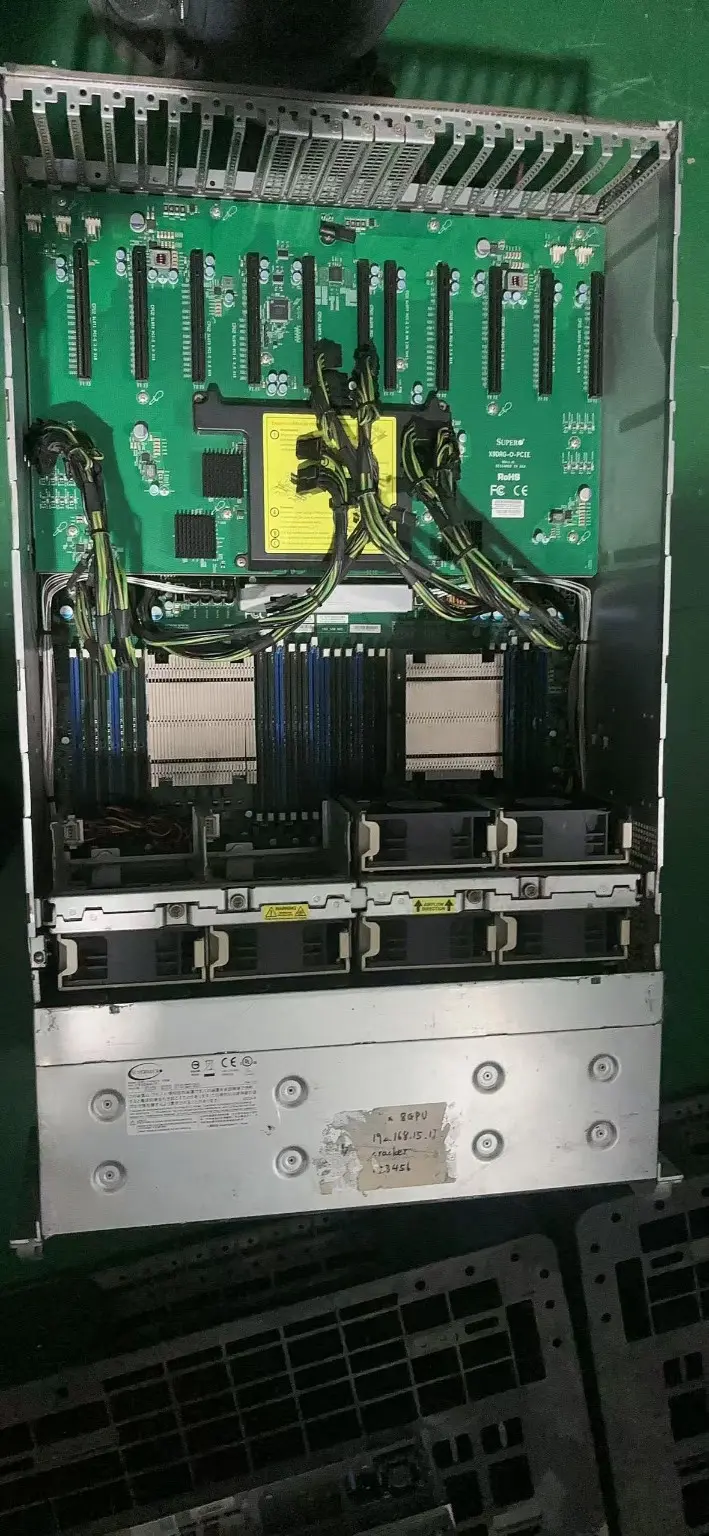
CMP 170HX是一张全被动散热的卡,卡上没有风扇。这意味着服务器那面风墙不是可选配件,不是散热加强包,而是这张卡的工作条件本身。没有风,硅片在自己的热量里窒息,像一座不通风的建筑从内部开始腐坏。8颗上万转的重型风扇昼夜不停,把整条风道灌满,导风罩必须完整,少一块挡板,气流就走捷径,某几张卡就在角落里默默过热,直到某天夜里掉卡,日志里只剩一行看不懂的错误。热不会喊疼,它只记账。
这面风墙有代价。上万转的风扇意味着持续的噪音、按千瓦计的风扇功耗、机柜里密度惊人的热排风。机器不能塞进普通办公室的角落,它需要真正的机架、真正的冷热通道、真正算过账的空调。买楼之前先看通风,这句话在这里是字面意思。
社区长期部署的共识,是把核心压在约70度的水平,显存热点压在75到80度;85度是工作上限,95度开始降速,98度关机。这些数字不该被当成日常运营目标,它们是灾难刻度,标着这栋楼在第几层开始塌、在第几层彻底放弃。日常目标应该离灾难刻度远一点,再远一点。
而且验证散热不能用轻载跑分糊弄。普通的FP32空转功耗很低,测不出真实的热画像。必须上真实的Tensor负载、真实的大模型、真实的长上下文,八卡同开,连跑八到二十四小时,盯着温度、功耗、错误日志,一页一页存下来。同一排卡里某一张明显更烫,先查硅脂、导热垫、散热器接触和风道,别急着怀疑芯片。风扇和电源一样是会耗损的部件,坏了就换,别等它罢工。废墟里活下来的楼,靠的不是某根柱子特别粗,而是每一根都还在,每一根都被检查过。检查很无聊,无聊到值得。
最后是那些更小的、几乎不好意思写进方案的东西。它们小到不配拥有章节,直到出事的那天,所有人才想起来它们有名字。
系统盘。卖方配置里那块孤零零的960GB SSD,不能作为最终交付形态。生产系统盘要两块企业级SSD做RAID1,互为镜像,一块死了另一块接着跑,业务无感。单盘不是省钱,是在地基里埋一根随时会断的梁,然后假装看不见它。镜像的意思是:同一份数据,写在两个地方,赌它们不会同时塌。赌注很便宜,值得下。
大容量NVMe做模型盘,放热模型、编译缓存,省下每天从网络重复拉大模型的时间;模型原件留在对象存储里,本地只是副本,烧了就再拉一份。4124原生四个NVMe位,老版本走Gen3,新版本可到Gen4,无论哪个,都够这个用途;4029原生是8个SATA加2个NVMe加一个M.2,本地模型空间明显更紧,这也是它甘居副本节点的原因之一。缓存这个词听起来像技术,本质是承认网络会慢、会断,提前把要用的东西放在手边。成熟的工程从不赌明天网络很好。
IPMI。一个独立于操作系统的管理口,机器死透了也能远程登进去看传感器、重启、挂载镜像。生产上要给它独立的VLAN,改掉默认口令。它无聊到没人愿意在会上提起,却是深夜报警时唯一还开着的那扇门。门不需要好看,需要在。
还有备件。GPU留百分之五到十的备卡池,电源、风扇、SSD有热备或现场件,配一套谁都会执行的换卡流程。二手硬件的可靠性不靠永不损坏,靠坏了能换、换了能好。这四个字比任何品牌承诺都便宜,也比任何品牌承诺都可靠。
网卡。4029板载双口10G,4124是双口25G。对企业推理已经够用:模型分发、对象存储、API入口、副本路由。但要诚实:25G就是25G,它不是两百G级的AI互连fabric,跨节点做服务路由和模型分发可以,别把它包装成训练集群的骨干。把接入网说成fabric的人,不是乐观,是在改图纸。无聊的网卡,做无聊的事,做得住,就是价值。
把这一部分从头看到尾,你会发现没有一句话是激动人心的。内存条数,电源颗数,电压伏数,风扇转速,盘的镜像,管理口的口令。这些东西放进任何一场发布会都会让全场睡着,它们没有叙事,没有光,没有可以剪成短视频的三秒钟。行业里所有响亮的话都留给了显卡,所有安静的事都留给了结构。响亮的话换来了围观,安静的事换来了活着。
可是企业买走的从来不是八张矿卡。企业买走的是一台有序列号、有烧机报告、有温度曲线、有监控告警、有备件、有换卡流程的设备,是坏一颗电源不停机、坏一块盘不丢数据、坏一张卡两小时内换上的承诺。显卡是这栋楼的租户,光鲜,喧哗,随时可能搬走;这些无聊的部分才是楼本身。租户换了一茬又一茬,楼还站着。企业付钱的时候,买的是楼还在这件事,不是某一任租户的演出。
废墟给的机会从来不是捡到宝贝。是把捡回来的结构,一根柱一根柱重新验过去:十二根还是十六根,每根有没有立着,电流够不够,风到不到,镜子里的那块盘还在不在。验完了,废墟才变成资产;验不完,资产只是还没塌的废墟,区别只在时间。
企业价值不藏在矿卡的显存里。它藏在DIMM清单里,藏在BIOS截图里,藏在PDU的电压标签里,藏在RAID1的第二块盘里,藏在那个改掉默认口令的下午里。藏在所有没人拍照的地方。而没人拍照的地方,恰好是楼站着的原因。
让软件承认硬件的残缺
这套节点真正开始工作以后,软件不能继续假装自己面对的是一批标准数据中心GPU。
宿主机要固定在Linux x86-64。社区解锁围绕特定版本的nvidia-open驱动工作,Secure Boot需要关闭,因为修改后的内核模块没有官方签名。这个条件并不优雅,却必须写进交付说明。隐藏它,只会让下一次系统重装变成一次考古:新驱动装上去,64GB消失,计算重新受限,所有人围着一台昨天还能工作的机器猜测发生了什么。
所以镜像比安装文档更重要。把内核、驱动、解锁配置、容器运行时和验证脚本一起冻结下来,保存一个真正启动过、跑过、验收过的版本。升级不是“跟随最新”,而是先在一台节点、一张卡上验证,再扩大范围。升级前记录显存、链路、温度和模型结果;升级后逐项对照。任何一项不一致,就退回原镜像。
容器也不是魔法。Docker或containerd加NVIDIA Container Toolkit,可以让服务部署更整齐,却不能把宿主机的脆弱隔离掉。容器里看到GPU之前,宿主机的修改驱动必须先稳定。通用GPU Operator如果自动接管驱动,很可能覆盖掉解锁环境。Kubernetes可以管理服务,不该擅自重写这栋楼的地基。
推理引擎同样要按边界选择。vLLM更适合作为主要在线推理引擎,llama.cpp适合烟测、GGUF、小模型服务和兼容路线。SGLang可以测试,但不能只因为名字出现在热门讨论里就成为默认。企业平台不是软件展览会。每多一个引擎,就多一套模型格式、启动参数、监控指标和故障解释。
社区样本已经证明这批卡能运行真实模型。单张64GB卡在特定量化、引擎和上下文条件下,可以跑数十到上百token每秒的解码,也可以通过并发获得更高聚合吞吐;八张64GB卡用流水线并行,甚至出现过运行超大MoE模型和长上下文的完整会话。这些记录很有价值,它们证明门能打开。
但能力证明不是SLA。
模型名称、量化方法、输入长度、输出长度、并发数、引擎版本、驱动和采样参数,只要改一项,数字就可能变化。113 tok/s不是170HX的固定速度,30.2 tok/s也不是八卡节点的永久铭牌。把社区的一次完整会话写成产品性能保证,就像看到一辆旧车下坡时跑到一个速度,便把那个速度刻进发动机规格。
真正能进入合同的,只能是客户模型在这台交付机器上的验收结果。
同一个模型,同一份权重,同一量化,同一上下文,同一并发,在指定驱动和引擎上跑出怎样的首token延迟、decode吞吐、聚合吞吐和错误率。验收后把环境一起封存。以后每次升级,用同一套题重新考试。跑分快一点不代表升级成功;显存少了一块、错误多了一次、某张卡开始掉速,都应该让升级停下来。
软件在这里承担的不是把旧卡伪装成新卡,而是让旧卡的每一种残缺都留下可观察的形状。服务路由知道哪张卡离线,监控知道哪张卡升温,镜像知道上一个可用版本在哪里,验收脚本知道今天的结果是否已经偏离昨天。
秩序不是把缺陷藏起来。
秩序是缺陷出现时,它不能继续匿名。
一张企业交付表,应该比配置单更难看
漂亮的配置单只写拥有了什么。真正的交付表还要写什么会坏。
每台服务器要有机型完整尾标、主板、riser、背板、CPU、DIMM、盘、网卡、PSU和序列号。每张GPU要有PCI ID、VBIOS、原始容量、解锁后容量、PCIe链路、温度曲线、功耗、显存测试和维修痕迹照片。每个软件镜像要有内核、驱动、解锁版本、容器运行时和模型引擎。每次烧机要有开始时间、结束时间、负载条件、异常和处理结果。
这张表不会好看。它会很长,会有空格,会有失败,会写着“这张卡温度偏高,已换导热垫复测”“这颗PSU告警,已更换”“这个NVMe健康度不合格,拒收”。它和销售材料的区别就在这里:销售材料负责让人想拥有,交付材料负责让人知道拥有以后要承担什么。
卡也应该分级。不是所有通过解锁的卡都进入同一池。根据显存测试、温度、功耗、链路、长负载错误和外观维修史,把卡分成生产、备用、观察和淘汰。生产卡进入节点;备用卡保持可随时替换;观察卡继续延长烧机;出现不可解释的HBM错误、反复掉卡或热异常,就退出交付范围。
节点也不能只记一个“通过”。八张卡共同运行时,最弱的一张会定义整机稳定性。单卡通过后再逐级增加,不只是为了减少排障难度,也是为了让问题拥有出生时间:一张时稳定,两张时稳定,四张时出现供电波动,八张时某个风道角落过热。没有这个过程,所有错误会在最终状态同时出现,像楼塌下来以后才开始找第一块松动的砖。
交付后还要规定死亡条件。连续出现什么Xid必须下线?显存测试出现一次错误是否允许重试?PCIe反复重训几次算故障?温度超过哪个阈值开始降载?服务进程异常退出多少次触发换卡?备卡换入后要重跑哪些测试?这些条件应该在事故发生前写下,不能等故障出现后由当班的人临时解释。
因为人在事故之后最擅长的事情,就是替自己找到一个“还能继续跑”的理由。
企业化恰恰要提前夺走这种解释权。达到死亡条件,节点退出;卡进入隔离;流量切走;换件;复测。没有“先观察几天”,没有“这次可能只是偶发”,除非观察本身也是一条有时间、有指标、有责任人的正式流程。
这就是二手硬件真正昂贵的部分。
卡可能便宜,服务器也可能便宜。可每一张表、每一次烧机、每一块备件、每一份镜像、每一次拒收,都要花时间。成本没有消失,只是从采购发票转移到了工程秩序里。谁只计算卡价,谁就会在交付以后收到另一张没有上限的账单。
而这张账单不会一次寄来。
它会在风扇老化时来一点,在驱动升级时来一点,在某张卡的HBM开始出现偶发错误时再来一点。楼不是在一个晚上突然变旧的。它每天掉一点灰,只是多数时候没人抬头。
方法反噬:标准化也会长出自己的裂缝
把旧硬件重新工程化,并不会把它变成新硬件。
ECC不会因为烧机通过而出现,NVLink和P2P不会因为部署文档写得漂亮而恢复,Gen2 x4也不会因为路由策略聪明就升级成Gen5 x16。社区驱动仍然不是厂商企业支持;一次内核升级,仍可能让已经稳定的节点重新回到不可用状态。Ampere的70SM、4480个CUDA Core和CC 8.0不会长出Blackwell的新架构能力,也不会凭空拥有FP8、FP4和现代企业卡的认证、保修与责任链。
标准化能做的是把风险照亮,不能把风险消灭。
它甚至会制造新的维护债。驱动冻结意味着你必须维护镜像;回滚意味着你必须保存旧环境;监控意味着告警规则会漂移;备卡意味着库存也要定期上电测试;SOP意味着每次硬件、内核和模型变化之后,都要重新验证。你建起一套秩序,秩序本身便开始老化。楼不再是废墟,但楼会漏水,消防门会被杂物堵住,图纸会被后来的人改错。
所以这套平台不能靠一次交付证明永远可靠。它只能靠持续点名,持续烧机,持续换卡,持续拒绝那些看起来已经足够完整的配置单。
企业买的其实是坏掉以后怎么办
与RTX PRO 6000 Blackwell比较时,最容易被滥用的是成本。
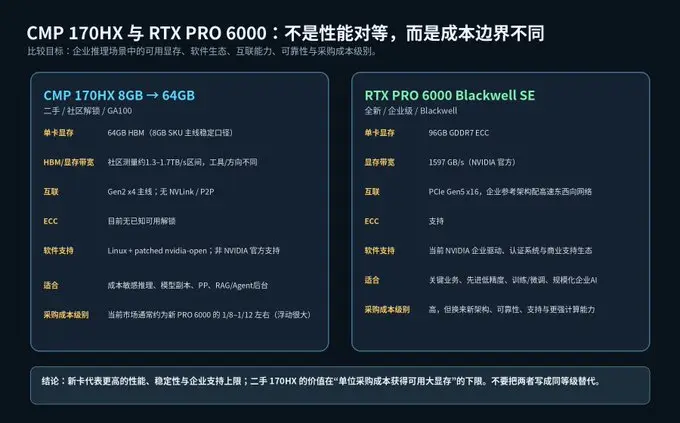
按照资料包截至2026年8月的公开市场样本,全新RTX PRO 6000与二手、可解锁CMP 170HX的单卡采购成本,大致相差约8—12倍,或者更稳妥地说,接近一个数量级。这句话可以写,但必须立刻把另一半写出来:它只描述采购成本,不描述性能等价,更不描述可靠性等价。
RTX PRO 6000有96GB ECC GDDR7、Blackwell架构、PCIe Gen5 x16、FP8和FP4能力、当前企业驱动、认证系统、保修和商业支持。170HX赢的是成本下限,是二手采购条件下的大显存与HBM带宽;它没有赢得架构上限,也没有赢得厂商替你承担故障的权利。
把成本差写成性能等价,就像因为废墟里的钢筋便宜,便宣布它和新楼拥有同一份质保。价格是真的,结论是假的。
真正可交付的产品名称,不该是“廉价A100集群”,也不该是“RTX PRO 6000平替”。它更接近“成本优化型大显存推理节点”或者“私有化AI算力节点”。客户买下的不是一张被解锁的矿卡,而是一台有序列号、有单卡档案、有温度曲线、有烧机报告、有监控、有备件、有回滚镜像的设备。
采购核对从机型完整SKU开始。4029或4124的尾标、主板、riser、背板、PSU数量都要逐项确认。“7402P×2”必须在付款或收货前由BIOS和lscpu拆穿。DIMM不能只写总容量,要列条数、单条容量、频率、Rank和CPU归属。PSU要看数量、型号、健康状态,也要确认机房是否提供220—240V高线输入。盘位背板、HBA、RAID、NVMe线缆、NIC、光模块和DAC都要有清单。IPMI必须能登录,默认弱口令必须消失。
单卡入库也不是看见nvidia-smi就结束。先用PCI ID分清8GB和10GB SKU,记录VBIOS、原始显存、PCIe链路、温度和功耗。检查PCB、腐蚀、封签、维修痕迹和供电口;确认EPS 8-pin逻辑,不能拿PCIe 8-pin强插。解锁后,8GB卡应当看到约64GB,10GB卡约40GB;随后必须做显存写读和地址模式测试。
整机上电要从一张卡开始,再到两张、四张、八张。每一级都观察12V、PSU、风扇、核心温度、HBM温度、掉卡和PCIe重训。最后八卡同时加载真实模型,跑HBM带宽、host到GPU带宽、Tensor或GEMM、长上下文和并发推理。不能拿一张卡通过替八张卡担保,也不能拿轻载FP32替真实热负载担保。
建议做8—24小时生产型持续烧机。保存每张卡的温度、功耗、Xid、AER、OOM、服务错误和异常退出。tokens/s必须和模型版本、量化、上下文、batch、引擎、驱动绑在一起,否则它只是一个失去现场的数字。
系统层同样要冻结。Linux x86-64、修改过的nvidia-open驱动、关闭Secure Boot,这条路径必须形成可复现镜像。禁止驱动自动升级,升级要灰度,失败要能退回已知版本。Docker或containerd可以承载服务,但容器稳定不能替宿主机驱动稳定。监控要同时看到IPMI的电源和风扇、NVML的温度与Xid、服务层的P50/P95、请求队列、tokens/s、OOM和重启次数。
最后留出5—10%的备卡池,连同PSU、风扇和SSD备件,写清换卡SOP。二手硬件的可靠性不是“永远不坏”,而是坏了能识别,能隔离,能换,换完能重新验收。企业真正购买的,是故障发生以后,现场不会重新退化成一片无人认领的废墟。
回到那行字
文章开始时,配置单上写着:7402P×2。
它只有一个字母不对。可那个字母足够让整栋想象中的楼失去一根承重柱。它提醒人们,系统最危险的时刻并不是报错,而是每一格都填满了,绿灯也亮着,于是所有人默认建筑已经完成。
八张卡可以亮起512GB。风扇可以满转。API可以返回。监控面板可以是一片绿色。
但绿灯不会告诉你那512GB是八间上锁的房间;不会告诉你某张卡没有ECC;不会告诉你双电掉一颗后接不住满载;不会告诉你驱动下一次升级是否还能回来;也不会告诉你那两颗CPU究竟是7402,还是一行从未被核验的文字。
废墟被重新通电时,最容易让人误以为它已经重建。真正的重建却发生在没有人愿意拍照的地方:BIOS截图、DIMM清单、PDU标签、第二块系统盘、烧机日志、备卡架和回滚镜像。
这些东西不能让矿卡变成旗舰,也不能让旧楼永远不塌。
它们只能让某一天裂缝出现时,有人知道裂缝在哪里,哪一层该停,哪一块材料该换,哪一份图纸仍然可信。
企业买的不是八张矿卡。
企业买的是那盏绿灯下一次撒谎时,谁敢先把它关掉。