这段时间我一直在折腾一张很奇怪的卡。
NVIDIA CMP 170HX。
它本来是一张几年前为了挖矿做出来的卡,二手市场上曾经便宜到几乎没人要。没有视频输出,没有正常消费级显卡的生态,PCIe 被限制,算力被限制,显存也被限制。
如果故事停在这里,它大概最后的归宿就是电子垃圾。
结果到了2026年,事情突然发生了变化。
社区发现,这张所谓的矿卡里面,其实是一颗真正的 GA100。
也就是 A100 那一代的核心。
然后一群人开始一点一点把 NVIDIA 当年关掉的东西重新打开。
算力打开了。
PCIe Gen2打开了。
显存打开了。
8GB版本变成64GB。
10GB版本变成40GB。
更离谱的是,10GB版本甚至已经被证明可以真正访问到接近80GB的地址空间。
于是,一张几年前几百块钱都没人要的矿卡,突然变成了2026年本地大模型圈子里最奇怪的一张AI卡。
我最近基本就是围着这个东西在折腾。
这篇文章,把目前我看到的、测到的,以及社区已经证明的东西全部整理一下。
一、先把最容易搞错的一件事说清楚
CMP 170HX目前主要有两个版本。
8GB版,PCI ID 是 "10de:20c2"。
10GB版,PCI ID 是 "10de:2082"。
现在正式公开的 cmpunlocker 对应关系是:
8GB → 64GB
10GB → 40GB
千万不要反过来。
目前主线版本就是这个状态,而且已经可以同时解除SM计算限制、显存几何限制和PCIe Gen2限制。
为什么会出现这么奇怪的结果?
正常直觉应该是10GB版本比8GB版本更好,怎么反而8GB最后变64GB,而10GB只有40GB?
答案藏在GA100的显存架构里面。
二、它不是简单地把64GB或者80GB显存藏起来了
网上现在很多说法把这个事情讲得过于简单。
有人说 NVIDIA 当年在170HX上装了80GB显存,然后故意只给你10GB。
严格来说,这个说法并不准确。
GA100的Framebuffer由很多个FBPA内存分区组成。
170HX 8GB版有:
16个活动FBPA
170HX 10GB版有:
20个活动FBPA
而两张卡出厂时,每个FBPA都只按照512MiB的容量档工作。
所以:
16 × 512MiB = 8GB
20 × 512MiB = 10GB
这就是它们原厂显存容量的来源。
社区后来发现,决定这个容量档的一个关键寄存器是 "CFG1"。
把8GB版本从512MiB/FBPA提高到4096MiB/FBPA:
16 × 4GB = 64GB
于是8G变64G。
而10GB版本现在主线采用的是2048MiB/FBPA:
20 × 2GB = 40GB
于是10G变40G。
真正疯狂的地方在下一步。
GA100实际上还存在4096MiB × 20这个内存几何。
也就是:
20 × 4GB = 80GB。
而这恰恰对应A100 80GB使用的那一级内存几何。
所以理论上,170HX 10GB版本还有一扇门。
10GB → 80GB。
这也是现在整个社区最值得看的实验。
三、80GB已经不是单纯的 nvidia-smi 假数字了
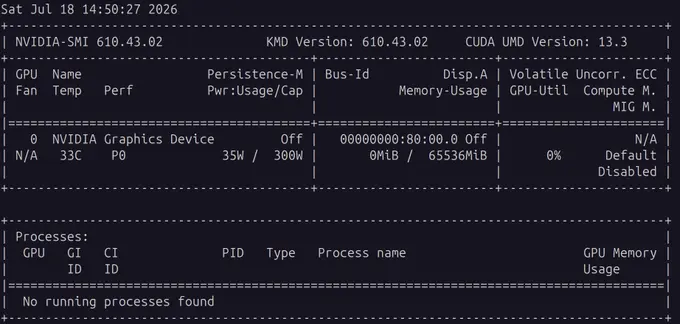
最早的80GB实验其实有问题。
当时有人确实让系统显示出了81920MiB,但是三个关键参数并不一致。
CFG1按照80GB配置。
driver又告诉系统有80GB。
但LMR实际上还停留在40GB。
结果就是:
看起来80GB。
实际上40GB以上发生地址折叠或者崩溃。
这也是为什么早期很多人说170HX的80GB是假显存。
这个判断在当时并没有错。
但后来实验往前走了一步。
社区重新做了一套 coherent 80GB 配置:
"CFG1 = 0x02779000"
"LMR = 0x0000028B"
两者都明确指向80GB。
然后不是只看nvidia-smi,而是直接进行dense tagged write/readback。
结果:
77.5GiB范围,310个测试块,310/310正确。
没有发现40GB地址折叠。
后来另一轮实验使用stock boot timing,也真正访问到了72GiB。
这个结果非常重要。
因为它基本否定了一个简单解释:
10G卡根本不存在40GB以上的真实地址空间。
至少目前来看,不是这样。
那些地址确实可以被写入。
而且数据能够正确读回来。
所以10G→80G现在真正的问题已经从:
有没有这些显存
变成了:
这些显存能不能稳定作为CUDA生产显存长期工作。
这是完全不同的问题。
四、80GB现在真正卡在哪里
目前还不能宣布10G已经成功解锁80GB。
原因很简单。
它不稳定。
coherent 80GB实验目前最大的几个问题是:
- 大约一个CUDA context之后可能出现Xid 154。
- 40GB以上区域的带宽大约只有正常峰值的79%。
- 最顶部大约2GiB还没有完成充分验证。
- 真正完成这一实验的操作者数量也非常少。
而且目前还没有把coherent 80GB方案做成一个普通用户可以安装的稳定driver路径。
所以我现在对10G版本的定义一直没有变。
40GB是产品。
80GB是彩票。
卖家如果因为能显示80GB就按80GB卡给你报价,我认为完全没有必要买单。
因为显示80GB和连续运行vLLM三天不掉卡,这是两个世界。
五、最近又发现了一个特别重要的40GB稳定性问题
这也是我最近一直盯GitHub的原因。
8月19日,cmpunlocker出现了一个非常值得关注的PR:
PR 32
cmpunlocker PR 32:WPR2 reserved region 修复
问题和WPR2有关。
简单解释就是,unlocker之前把显存顶部的一块reserved region错误地重新交给了显存分配器。
但是那块区域根本不是空闲显存。
里面住着GSP firmware和heap。
在10G→40GB卡上,大约涉及139MiB。
平时可能完全感觉不到。
为什么?
因为PMA首先使用正常显存池。
只有当显存快被吃完的时候,才会跑到那块区域。
这就解释了一个非常奇怪的现象。
很多170HX平时运行完全正常。
模型也正常。
CUDA也正常。
但是把显存打到90%以上甚至接近满的时候,突然:
Xid 31。
REGION_VIOLATION。
cudaErrorIllegalAddress。
然后scrub卡死。
最后Xid 154。
整个GPU只能重启。
10G→40GB卡已经真实出现过这个问题,包括LoRA weight patch过程中出错。
PR 32做的事情其实很简单。
不要把这块WPR2区域交给PMA。
修完以后,再做极限测试。
有人直接:
cudaMalloc一直分配。
然后对每一块内存cudaMemset。
直到显存只剩5.4MiB。
结果:
0 Xid。
0 scrub fault。
CUDA仍然正常。
而且这个问题后来在8G→64GB版本也被复现并验证了修复。
这件事情对我来说反而是利好。
因为最怕的是硬件随机坏。
如果是HBM随机不稳定,那几乎无解。
现在至少这个故障已经被定位到非常具体的内存区域管理bug,而且修复逻辑非常明确。
截至我写这篇文章的时候,PR 32仍然处于Open状态,还没有正式进入master。
所以目前我的判断是:
40GB已经很好用,但在PR 32正式合并之前,我不会把10G→40GB称为完全稳定版。
六、验证工具自己甚至也踩了一个坑
同一天还有PR 33。
这个问题更加有意思。
以前有人跑完unlock以后执行 "verify 脚本"。
显示成功。
大家自然认为所有卡都成功了。
后来发现,如果你安装unlocker以后又往机器里加了170HX,旧版本verify可能继续读取安装时候记录的GPU inventory。
结果:
机器里明明有3张170HX。
它只验证其中1张。
最后依然告诉你:
全部成功。
更麻烦的是,一些Ubuntu或者Debian环境默认禁止普通用户读取dmesg,脚本还可能把没有权限读取日志误认为日志不存在。
所以以后看170HX实测,我已经不太相信一句:
verify passed。
真正可信的测试应该至少包括:
- 逐卡PCI ID。
- 实际memory total 字段。
- CFG1/LMR。
- dense fold test。
- CUDA真实allocate/write/read。
- 长时间serving。
- Xid日志。
如果是多卡,更应该逐张检查。
这也是这段时间玩170HX以后,我越来越强烈的一个感觉:
这个项目现在已经不能靠截图判断真假了。
七、真正让我开始认真看这张卡的,是大模型实测
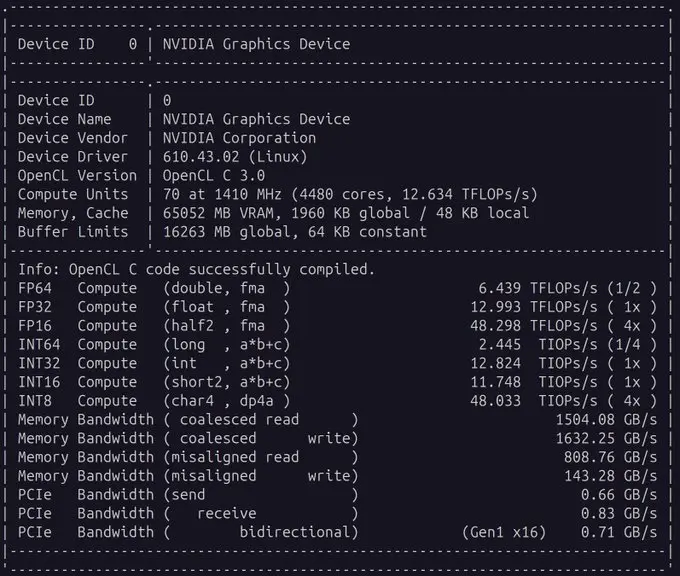
破解显存本身很好玩。
但如果只是nvidia-smi多显示几十GB,我不会这么兴奋。
真正改变我判断的,是这张卡开始跑新一代大模型了。
尤其是Qwen3.8-27B。
我自己第一轮测试,大约跑到了:
70 tokens/s左右。
而且当时还没有怎么优化。
这已经让我觉得它有意思了。
后来社区公开数据越来越多。
有人使用单张8G→64GB的170HX,在vLLM里运行:
"Qwen3.8-27B-SmoothQuant-W8A8-INT8"
BF16 KV。
MTP=3。
没有进行特别深的优化,就跑出了:
约1500 tok/s prefill
95~103 tok/s decode。
这已经不是能不能跑的问题了。
这是一个正常可用的本地27B AI服务器速度。
另外还有一套特别有意思的配置。
Strix Halo主机。
CMP 170HX通过USB4 eGPU连接。
vLLM。
Qwen3.8-27B INT8 W8A16。
MTP3。
262K最大上下文。
结果单stream:
3000~4000 tok/s prefill
40~60 tok/s generation。
而且测试者称context增加以后,对decode速度影响并不大。
注意。
这是USB4外接一张几年前的矿卡。
事情发展到这个程度,本身已经很荒诞了。
八、但单用户100 tok/s还不是170HX真正有意思的地方
很多人看本地模型,只看一个数字:
tokens/s。
然后拿170HX和5090比较。
我现在觉得这种比较越来越没有意义。
因为真正做Agent或者AI服务的时候,你面对的不是:
一个人问一句话。
而是:
Agent A调用模型。
Agent B同时调用模型。
工具返回以后再次调用。
后台任务调用。
前端用户调用。
定时任务调用。
这时候真正重要的是:
continuous batching。
aggregate throughput。
而170HX最近开始出现真正的serving数据了。
例如公开的SGLang Qwen3.6-27B W8A8测试。
10G→40GB版本,在最大并发4、MTP开启的时候:
2048 input / 512 output:
222.57 output tok/s aggregate
2048 / 1024:
254.04 tok/s
2048 / 2048:
269.31 tok/s。
8G→64GB版本则更夸张。
相同类型测试:
2048 / 512:
308.74 tok/s
2048 / 1024:
367.00 tok/s
2048 / 2048:
382.14 tok/s aggregate。
当然,这两个测试环境不是严格意义上的只改变显存容量A/B,所以不能直接得出8G硬件一定比10G快40%。
但它至少证明了一件事情。
170HX完全有能力做多用户LLM serving。
这和我一开始判断这张卡的逻辑已经完全不同了。
九、甚至已经有人开始做长时间并发稳定性
还有一个我非常喜欢的项目叫170tune。
它有一个理念我特别认同:
Benchmark跑完,不代表这张卡是稳定的。
因为GPU最可怕的故障不是crash。
而是:
程序正常结束。
没有Xid。
没有报错。
但是算出来的数据错了。
所以170tune里面有完整的full-VRAM pattern sweep、bit-exact GEMM、温度gate和真实workload qualification。
他们拿解锁64GB的170HX跑vLLM。
并发16的时候:
204.87 tok/s aggregate
TTFT约795ms。
功耗约157W。
128个请求全部完成。
再继续优化以后,并发24:
298.9 tok/s decode aggregate
2744 tok/s prefill
TTFT约481ms。
功耗约170W。
最关键的是:
后来继续跑了31分钟。
3552个请求。
0失败。
吞吐波动控制在0.6%以内。
HBM稳定在68℃。
这类数据对我的价值,比再多一个nvidia-smi 64GB截图高一百倍。
因为这说明它正在从:
破解玩具
走向:
服务器设备。
十、这张卡真正麻烦的,其实是散热
170HX是被动散热卡。
它原本就是设计给服务器风道的。
放进普通PC机箱里,是完全另外一回事。
社区已经有人报告,散热不好的170HX一分钟左右就冲到85℃,然后开始严重降频;换成正确的强风道以后,250W运行也有人能控制在67℃附近。
170tune的测试更加说明温度的重要性。
HBM超频在冷状态下测试通过,热起来以后可能直接出现数据错误。
他们最终甚至明确要求:
真实serving qualification必须热测。
不能因为cold benchmark过了就宣布稳定。
所以我以后如果正式把170HX作为生产服务用,我会把这几件事情当成一个整体:
- GPU温度。
- HBM温度。
- 风量。
- 功耗限制。
- 显存完整性。
- Xid。
- serving错误率。
不能只盯核心温度。
十一、PCIe也是一个很有意思的问题
170HX原厂PCIe非常残。
软件现在已经可以把它从Gen1 x4提升到:
PCIe Gen2 x4。
这个已经进入公开unlocker。
但注意:
Gen2和x4是两个东西。
PCIe代际可以通过软件解锁。
位宽不行。
PCB上为了限制这张卡,部分PCIe lane相关元件本身就被删掉了。
社区确实做过物理补电容以后Gen2 x16的实验,而且观察到6.6GB/s左右传输,但这不是普通用户一条命令可以打开的功能。
所以多卡170HX不能简单想象成:
插四张就等于四张A100。
模型如果频繁跨GPU通信,PCIe会成为一个非常现实的问题。
但如果是一张卡跑一个完整模型,或者不同GPU分别跑不同服务,这个问题就小很多。
我反而觉得这才是170HX最舒服的玩法。
不要硬凑Tensor Parallel。
把每张64GB卡当成一个独立AI节点。
十二、8G和10G,我现在的判断越来越明确
如果今天让我重新评价这两个版本,我会这么说。
8G版本
这是价值已经兑现的版本。
8GB → 64GB。
大量复现。
Qwen。
vLLM。
SGLang。
ComfyUI。
都已经开始出现真实数据。
风险当然仍然存在,尤其是unlock driver、散热和硬件老化。
但它已经不是单纯买彩票。
64GB是真的产品能力。
10G版本
这张卡反而更有意思。
因为现在正式能力只有:
40GB。
如果故事停在40GB,我认为它的价值其实低于8G→64GB版本。
但是它拥有那个非常特殊的80GB可能性。
所以我一直把它看成:
一张40GB GPU + 一张免费的80GB期权。
如果最后80GB失败。
你还有40GB。
如果80GB成功。
整张卡会被重新定价。
十三、而且我现在甚至不执着于一定要80GB
这是我最近想法变化比较大的地方。
假设80GB顶部的一些区域确实很难稳定。
那为什么一定要80?
60GB行不行?
64GB行不行?
72GB行不行?
目前文档已经明确提到,10G版本要做48/56/60/64这样的中间档,不能单纯依靠CFG1,因为per-FBPA tier是粗粒度的。
但理论上可以:
CFG1保持80GB级别。
然后通过driver-visible size和PMA region限制真正开放的容量。
比如最终发现:
0~68GB百分之百稳定。
68~80GB存在问题。
那我根本不需要80GB。
直接做一个:
10G → 64GB stable profile
对实际用户来说,价值可能比一个经常Xid 154的80GB高得多。
我甚至觉得这可能是10G版本最终真正的突破口。
十四、价格已经开始脱离矿卡逻辑
最荒诞的一幕其实已经发生了。
以前170HX就是矿难垃圾。
后来unlock公开以后,市场开始疯狂重新定价。
Tom's Hardware最新报道提到,原来大约250美元级别的CMP 170HX,在unlock消息传播以后已经被推到了1000美元以上。
社区里也已经有人遇到:
谈好价。
付款。
卖家突然发现170HX涨价。
然后要求买家退款,再用接近两倍价格重新买。
所以现在买170HX已经不能再按照捡垃圾的逻辑看了。
以前买的是废矿卡。
今天买的是:
GA100。
大容量HBM。
Linux推理节点。
以及未来unlock进度。
这几样东西叠加起来,市场肯定会重新定价。
十五、我对未来价格的判断
这是判断,不是事实。
如果8G→64GB继续稳定,而且Qwen3.8这一代模型持续有人跑到100 tok/s上下,再加上多用户serving不断出现成熟数据,我认为8G版会逐渐形成一个比较明确的二手AI硬件价格锚。
但它不会无限涨。
因为价格涨到一定程度以后,R9700、3090多卡、5090、专业卡甚至其他二手数据中心GPU都会进入比较范围。
170HX最大的优势,从来都不是它是一张A100。
它不是A100。
它最大的优势是:
以一个非常奇怪的价格,拿到GA100 + 64GB HBM。
价格越高,这个优势越弱。
10G则不同。
如果只能40GB,我认为长期应该明显低于8G版。
但如果未来出现:
80GB stable driver。
70GB以上真实模型加载。
连续多个CUDA context。
24小时以上vLLM/SGLang。
0 Xid。
完整VRAM integrity test。
那它会发生第二次重新定价。
那时候10G反过来比8G贵,我一点都不会意外。
十六、我现在真正盯的已经不是80GB三个字
我已经专门把这条线做成持续监控了。
现在我盯的东西包括:
10G→80GB coherent driver。
PR 32 WPR2修复什么时候进入master。
PR 33验证工具修复。
新的stable release。
Xid 31。
Xid 154。
显存地址折叠。
silent memory corruption。
不同10G硬件批次。
HBM差异。
vLLM稳定性。
SGLang稳定性。
CUDA context数量。
长上下文。
并发吞吐。
功耗。
温度。
PCIe。
甚至二手价格和卖家宣传。
因为到了这个阶段,任何一个细节都可能直接改变这张卡的估值。
截至本文写作时,主仓库仍然显示两个Open PR,也就是PR 32和PR 33。主线公开能力仍然明确写着:
8GB → 64GB。
10GB → 40GB。
PCIe Gen2。
这就是我目前认为最应该相信的基线。
项目地址:
170tune:
技术资料我也非常建议看社区整理的CMP 170HX Wiki,其中把显存几何、Falcon、GA100、PCIe以及大量失败实验都整理得非常完整。
十七、接下来,轮到我自己加入80GB这场实验了
现在我人在外地。
卡已经可以装上。
等我回去以后,大概两三天,我准备正式加入10G→80GB这一条实验线。
但我不会把目标定成:
让nvidia-smi显示80GB。
那个阶段已经没有意义了。
我真正想验证的是:
- 80GB能不能跑真实模型。
- 能不能连续创建CUDA context。
- 40GB以上显存真实带宽是多少。
- 显存打到70GB以后会不会Xid。
- vLLM能不能连续serving。
- SGLang能不能跑并发。
- 长上下文到底能推到哪里。
如果80GB不稳定,就继续往下找:
72GB。
64GB。
60GB。
最终找到一条真正能长期工作的边界。
我觉得这才是10G版真正值得做的事情。
十八、最后说一点我最近最大的感受
玩170HX这件事情,最开始其实非常简单。
就是觉得好玩。
一张几年前的矿卡,居然还能破解。
然后慢慢看资料。
看寄存器。
看GA100。
看HBM。
看Falcon。
看GSP。
看CUDA。
看vLLM。
看SGLang。
最后突然发现,这件事情已经不只是破解一张显卡了。
它其实把现代GPU工业里一个很少有人真正接触到的东西暴露了出来。
我们平常买一张GPU,会觉得:
64GB就是64GB。
10GB就是10GB。
算力就是参数表里的算力。
PCIe就是参数表里的PCIe。
但是170HX告诉你:
有时候并不是这样。
芯片真正拥有什么。
厂商允许你使用什么。
驱动告诉操作系统什么。
产品经理决定卖给你什么。
这是四件不同的事情。
170HX最迷人的地方,就在这里。
2021年 NVIDIA 看着这颗GA100,说:
这是一张10GB矿卡。
2026年一群人把它拆开以后说:
不对。
这里还有东西。
然后一层一层把门打开。
10GB。
40GB。
64GB。
80GB。
Gen2。
完整算力。
然后把Qwen3.8放进去。
100 tokens/s。
再接vLLM。
再跑几十个并发请求。
事情突然就变得非常赛博朋克。
所以我现在对170HX的态度依然是:
不要神化它。
它不是A100。
没有官方支持。
驱动是patch的。
Secure Boot要关。
PCIe残废。
NVLink现在也没有。
ECC也还没有恢复。
散热非常折腾。
甚至有些问题可能永远解决不了。
但是也不要低估它。
因为一张原本已经被整个市场判死刑的矿卡,现在正在重新变成一台AI服务器。
而且这个故事,还没有结束。
尤其是那张10G版。
40GB已经在手里。
80GB的门,也已经被推开了一条缝。
接下来要做的,就是看看门后面的东西,到底能不能真正拿出来用。